
Wann hilft Frequenzzerlegung physik-informierten neuronalen Netzen?
Shubham Rai, Forschungspraktikant bei Bibha, hat ein zweizweigiges, spektral gesteuertes PINN gebaut, damit sich jeder Teil einzeln abschalten lässt. Die Ablation zeigt, dass Frequenzzerlegung bei mehrskaligen Wellenproblemen lohnt und bei glatten, einskaligen Problemen nichts bringt oder sogar schadet.
Welche Frage stellt das Paper?
Das Paper fragt, wann Frequenzzerlegung ein physik-informiertes neuronales Netz tatsächlich verbessert, statt anzunehmen, dass sie es immer tut. Shubham Rai, Forschungspraktikant bei Bibha mit Unterstützung des Engineering-Teams, beantwortet sie mit einer kontrollierten Ablation über fünf eindimensionale PDE-Testfälle steigender spektraler Komplexität.
Physik-informierte neuronale Netze, kurz PINNs, nehmen die Differentialgleichung samt Rand- und Anfangsbedingungen in die Trainingsverlustfunktion auf, sodass das Netz die Physik erfüllen muss und nicht nur beobachtete Daten anpasst. Sie gehören inzwischen zum Standardwerkzeug des wissenschaftlichen maschinellen Lernens, erben aber eine bekannte Schwäche gradiententrainierter Netze: den spektralen Bias. Niederfrequente Anteile einer Lösung werden schnell gelernt, hochfrequente langsam oder gar nicht.
Es gibt eine Familie von Gegenmitteln, von Fourier-Merkmalen und sinusförmigen Aktivierungen bis zu Gebietszerlegung und Gating. Die meisten dieser Arbeiten argumentieren, reichere spektrale Darstellungen hälfen generell. Das Paper vertritt die Gegenposition: Physikalische Systeme unterscheiden sich stark in ihrem spektralen Charakter, der Nutzen sollte also vom Problem abhängen. Nur wenige Studien hatten frequenzbewusste Architekturen gegen passende Ablationen über PDEs unterschiedlicher Komplexität verglichen, und diese Lücke will die Studie schliessen.
Die DBSG-PINN-Architektur, gebaut zum Zerlegen
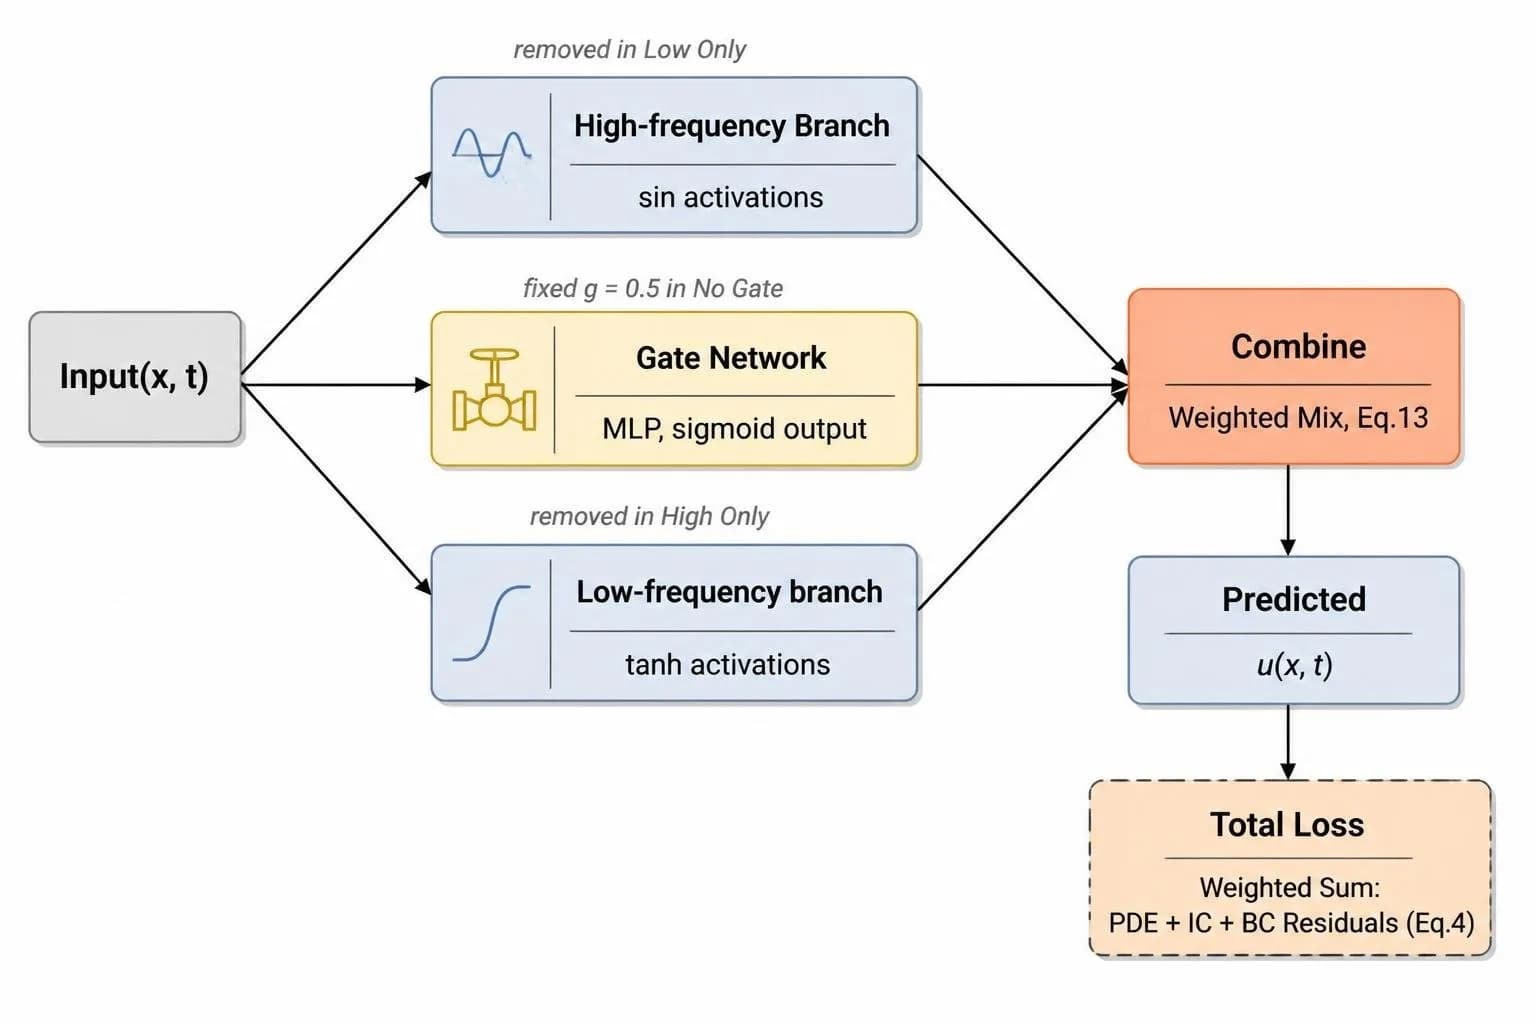
DBSG-PINN, das Dual-Branch Spectral-Gated PINN, teilt die Approximation in zwei Teilnetze und ein gelerntes Gate auf, und jede Komponente lässt sich entfernen, ohne den Optimierer anzurühren. Genau das ist der Zweck: Die Architektur wird zum Instrument für Ablationen statt zum Produkt.
Der Niederfrequenzzweig nutzt Tangens-hyperbolicus-Aktivierungen, die klassische glatte Nichtlinearität, um sanfte Lösungsanteile zu erfassen. Der Hochfrequenzzweig nutzt sinusförmige Aktivierungen im Stil von SIREN-Netzen, um oszillierendes, mehrskaliges Verhalten darzustellen. Beide Zweige erhalten dieselben Orts- und Zeitkoordinaten und trainieren gemeinsam, Ende zu Ende, ohne Vortraining oder eingefrorene Teile.
Ein kleines Gate-Netz erzeugt an jedem Punkt in Raum und Zeit einen Sigmoid-Wert zwischen 0 und 1. Die endgültige Vorhersage ist eine Konvexkombination: Gate-Gewicht mal Hochfrequenzzweig plus eins minus dieses Gewicht mal Niederfrequenzzweig. Weil genau zwei Zweige gemischt werden, ersetzt ein skalares Sigmoid den Softmax aus Mixture-of-Experts-Modellen.
Der Autor achtet auf die Sprache. Die Zweignamen beschreiben einen beabsichtigten induktiven Bias der Aktivierungsfunktion, keine formale spektrale Trennung. Nichts hindert einen der Zweige daran, jede Funktion darzustellen, die seine Tiefe erlaubt; das Gate entscheidet, wie viel jeder wo beiträgt.
Wie wurden die Ablationsvarianten gebaut?
Jede Variante ist derselbe Berechnungsgraph, in dem eine Komponente strukturell entfernt oder festgesetzt wurde, trainiert aus einer frischen Initialisierung mit demselben Optimierer, demselben Iterationsbudget, derselben Kollokationsstrategie und denselben Verlustgewichten wie das vollständige Modell. Nur die aktiven Architekturteile ändern sich.
Die vier Varianten prüfen zwei Fragen. Full gegen NoGate fragt, ob ein gelerntes Gate einen festen Mittelwert schlägt, denn NoGate hält das Gate bei 0,5 fest. LowOnly und HighOnly gegen Full fragen, ob ein einzelnes Frequenzregime genügt, indem sie den Hochfrequenz- beziehungsweise den Niederfrequenzzweig weglassen.
Das Paper nennt eine Einschränkung vorneweg, statt sie zu verstecken. Die beiden Zweige sind nur grob kapazitätsgleich: Auf den meisten Testfällen ist der Hochfrequenzzweig breiter, etwa 64 gegenüber 32 Einheiten bei Multimodale Welle und 128 gegenüber 64 bei 1D-Welle, und anderswo weicht die Tiefe um ein oder zwei Schichten ab. LowOnly gegen HighOnly ist also kein sauberer Test von Tanh gegen Sinus für sich. Selbst gleiche Parameterzahlen würden keine gleiche Ausdruckskraft der beiden Aktivierungsfamilien garantieren.
Das Training folgt gängiger PINN-Praxis: eine Adam-Phase für den schnellen Abstieg, dann L-BFGS zur Verfeinerung nahe dem Minimum. Die Verlustgewichte sind je Testfall fest, sodass alle Varianten dieselbe Verlustlandschaft teilen.
- Full (vollständig). Beide Zweige aktiv, an jedem Punkt in Raum und Zeit vom gelernten Gate gemischt.
- NoGate (ohne Gate). Beide Zweige aktiv, aber das Gate ist bei 0,5 festgesetzt, also ein einfacher Mittelwert beider Ausgaben.
- LowOnly (nur niederfrequent). Hochfrequenzzweig und Gate sind entfernt; die Vorhersage ist allein der Tanh-Zweig.
- HighOnly (nur hochfrequent). Niederfrequenzzweig und Gate sind entfernt; die Vorhersage ist allein der Sinus-Zweig.
Fünf Testfälle und sechs Metriken
Die Testfälle wurden so gewählt, dass sie die spektrale Komplexität abdecken: Burgers, Reaktions-Diffusion, Allen-Cahn, die gewöhnliche 1D-Wellengleichung und eine multimodale Wellengleichung, deren Lösung drei räumliche Moden überlagert. Jeder wurde auf einem gleichmässigen Gitter von 100 mal 100 Punkten in Raum und Zeit ausgewertet.
Multimodale Welle ist der spektral reichste Fall. Die Anfangsbedingung kombiniert die Moden 1, 3 und 5 mit den Amplituden 1,0, 0,7 und 0,4, und die geschlossene Lösung lässt alle drei Moden in der Zeit schwingen. Am anderen Ende stehen Reaktions-Diffusion, ein einzelnes Sinusprofil, das wächst oder abklingt, und 1D-Welle, eine einzelne Mode bei Wellenzahl 4. Burgers wird durch die Viskosität fast einskalig geglättet, und Allen-Cahn ist glatt bis auf scharfe, lokal begrenzte Übergangsschichten.
Die Genauigkeit wird als relativer L2-Fehler und maximaler punktweiser Fehler berichtet, gemäss der Konvention des ursprünglichen PINN-Papers, die auch die Bibliothek DeepXDE übernommen hat. Ein mittleres PDE-Residuum, nach dem Training mit finiten Differenzen auf dem Auswertegitter berechnet, dient als Konsistenzprüfung und nicht als Mass der vom Optimierer minimierten Grösse.
Drei spektrale Diagnosen übertragen die Fourier-Sicht auf den spektralen Bias auf eine trainierte Lösung. Das Amplitudenspektrum der Vorhersage wird mit dem der Referenz über Wellenzahlen bis 20 verglichen, ohne den Mittelwert. Die Moden 2 bis 5 bilden ein Niederfrequenzband und die Moden 6 bis 20 ein Hochfrequenzband, jeweils zusammengefasst in einem Recovery-Wert, der 1 erreicht, wenn die Spektren übereinstimmen. Der Autor weist darauf hin, dass das Hochfrequenzband bei einmodigen Testfällen kaum Referenzenergie enthält, sodass sein Recovery-Wert sich wie ein Rauschbodenindikator verhält und nicht wie ein Genauigkeitsmass.
Was hat die Frequenzzerlegung auf jedem Testfall verändert?
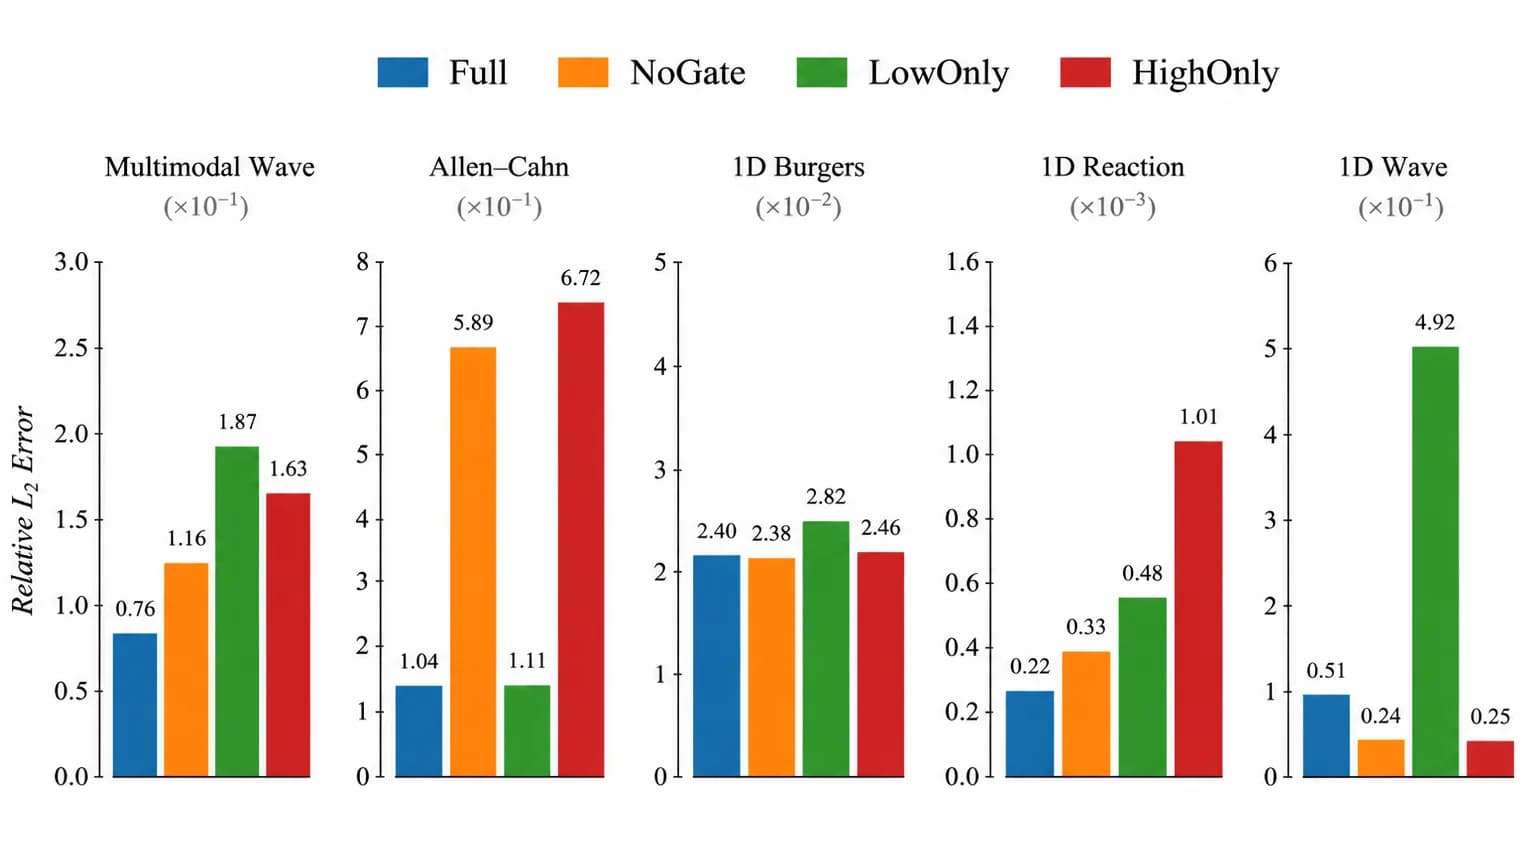
Die Zerlegung half am meisten beim wirklich mehrskaligen Ziel und am wenigsten bei den einfachsten. Bei Multimodale Welle lag das vollständige Modell auf fast jeder Metrik vor jeder Ablation, mit einem relativen L2-Fehler von 0,0762 gegenüber 0,1161 für NoGate, 0,1869 für LowOnly und 0,1632 für HighOnly, die Quelle der im Abstract genannten Verbesserung um bis zu 59,2 %.
Allen-Cahn war knapper. Full blieb vor LowOnly, 0,1038 gegenüber 0,1108 beim relativen L2-Fehler, während NoGate und HighOnly weit zurückfielen. Die angebotene Deutung: Das Gate hatte hier die Aufgabe, einen sinusförmigen Zweig zu unterdrücken, der nicht zu einer überwiegend glatten Lösung passte, statt zwei nützliche Zweige zu mischen, und ein anderer Seed könnte die knappe Reihenfolge von Full und LowOnly plausibel umkehren.
Burgers war ein Unentschieden. Full und NoGate lagen beim relativen L2-Fehler nur wenige Tausendstel auseinander, 0,0240 gegenüber 0,0238, wobei jede Variante auf etwa der Hälfte der Spalten vorn lag, jeweils um weniger als 5 %. Die Viskosität lässt kaum spektrale Struktur übrig, zwischen der ein Gate wählen könnte.
Reaktions-Diffusion ist der sperrige Fall. Die Lösung ist eine einzelne räumliche Mode, und dennoch führte das vollständige Modell bei jeder Genauigkeitsmetrik. Der Autor zwingt das nicht in die Erzählung von der spektralen Komplexität, sondern hält es als offene Frage fest.
1D-Welle lief in die andere Richtung, und nicht nur knapp. NoGate schlug das vollständige Modell bei jeder erfassten Metrik, um rund 53 % beim relativen L2-Fehler und 68 % beim spektralen Fehler. Mit einer einzigen Wellenzahl gab es für das Gate nichts zu verteilen, und ein Gate zu lernen schadete gegenüber einem festen Mittelwert aktiv. Das Paper bietet keine sichere Erklärung an und nennt eine Nachuntersuchung mit mehreren Seeds als Priorität.
| Testfall | Full (mit Gate) | NoGate-Variante | LowOnly-Variante | HighOnly-Variante |
|---|---|---|---|---|
| Multimodale Wellengleichung | 0,0762 | 0,1161 | 0,1869 | 0,1632 |
| Allen-Cahn-Gleichung | 0,1038 | 0,5892 | 0,1108 | 0,6717 |
| Burgers-Gleichung | 0,02398 | 0,02383 | 0,02816 | 0,02455 |
| Reaktions-Diffusions-Gleichung | 0,000224 | 0,000325 | 0,000477 | 0,00101 |
| 1D-Wellengleichung | 0,05134 | 0,02397 | 0,49170 | 0,02514 |
Was legt das Verhalten des Gates nahe?
Über die Testfälle hinweg skalierte der Nutzen des Gates mit dem spektralen Reichtum: am grössten bei Multimodale Welle, kleiner, aber positiv bei Allen-Cahn, etwa neutral bei Burgers und negativ bei 1D-Welle. Diese Reihenfolge passt zu einem Gate, das Frequenzstruktur ausnutzt, statt Rauschen hinzuzufügen.
Der Autor sagt ausdrücklich, dass dies aus aggregierten Vergleichen gefolgert ist, nicht aus einer Betrachtung der räumlichen Aktivierungen des Gates. Eine direkte Visualisierung des Gate-Werts gegen den lokalen spektralen Gehalt wird als Voraussetzung genannt, bevor das Muster als Eigenschaft der Architektur gelten kann. Reaktions-Diffusion, wo das Gate trotz einmodigem Ziel half, bleibt das Gegenbeispiel, das die Aussage vorläufig hält.
Warum sich das Paper selbst vorläufig nennt
Drei Einschränkungen begrenzen die Ergebnisse, und das Paper benennt sie, statt sie den Lesern zu überlassen. Jedes Ergebnis stammt aus einem einzigen Trainingsseed, es gibt also keine Varianzschätzung; die knappe Lücke bei Allen-Cahn und die grosse Lücke bei 1D-Welle sind beide dieser Unsicherheit ausgesetzt.
Die Kapazität der Zweige ist nur grob abgeglichen, und selbst gleiche Grössen würden die funktionale Kapazität von Tanh- und Sinus-Netzen nicht gleichsetzen. Alle fünf Testfälle sind eindimensional, über höhere Dimensionen oder stärkere Nichtlinearität wird also nichts behauptet.
Die Danksagung ist ebenso direkt: Die beiden Übersichtsabbildungen entstanden mit einem KI-Diagrammwerkzeug und der Manuskripttext wurde mit einem KI-Assistenten sprachlich überarbeitet, wobei der Autor jede Ausgabe geprüft hat und die Verantwortung für die Forschung selbst trägt.
Was als Nächstes kommt und warum es für angewandte KI zählt
Der genannte nächste Schritt ist, die Ablation über mehrere Seeds zu wiederholen, um zu sehen, ob die Reihenfolgen halten. Darüber hinaus schlägt das Paper vor, auf zweidimensionale und zeitabhängige mehrskalige PDEs zu erweitern, aus dem spektralen Gehalt der Anfangs- und Randdaten eine leichte Diagnose zu bauen, die vorhersagt, ob Zerlegung hilft, und das Gate über diese Architektur hinaus als Interpretierbarkeitssignal zu prüfen.
Für Teams, die Modelle auf Bibha bauen, zählt die Methode so viel wie das Ergebnis. Eine Architektur als Instrument zu behandeln, den Optimierer festzuhalten, jeweils eine Komponente zu entfernen und auch die Fälle zu berichten, in denen das reichere Design verlor, sind dieselben Gewohnheiten, die unsere Plattform mit ihren Werkzeugen für Evaluation und Freigabeentscheidungen fördert. Einen Kandidaten mit einer Basislinie auf repräsentativen Fällen zu vergleichen und die Belege hinter einer Entscheidung aufzubewahren gilt für ein PINN genauso wie für ein Modell in einem Geschäftsworkflow.
Fragen und Antworten
Was ist spektraler Bias bei physik-informierten neuronalen Netzen?
Spektraler Bias ist die Neigung gradiententrainierter neuronaler Netze, die niederfrequenten Anteile einer Zielfunktion deutlich früher zu lernen als die hochfrequenten. Bei PINNs zeigt er sich als Schwierigkeit mit scharfen Gradienten, Oszillationen und Lösungen, die mehrere räumliche oder zeitliche Skalen mischen. Fourier-Merkmale, sinusförmige Aktivierungen, adaptive Verluste und Gebietszerlegung sind die üblichen Gegenmittel, und dieses Paper fragt, wann sich solche Gegenmittel tatsächlich auszahlen.
Was ist DBSG-PINN?
DBSG-PINN ist das im Paper vorgestellte Dual-Branch Spectral-Gated physik-informierte neuronale Netz. Ein Tanh-Zweig modelliert glatte Anteile, ein sinusaktivierter Zweig modelliert oszillierende Anteile, und ein kleines Gate-Netz mischt beide Punkt für Punkt mit einem Sigmoid-Gewicht. Jede Komponente lässt sich entfernen, ohne den Optimierer zu ändern, und genau das macht die Architektur für eine kontrollierte Ablationsstudie geeignet.
Verbessert Frequenzzerlegung die PINN-Genauigkeit immer?
In dieser Studie nicht. Beim spektral reichen Testfall Multimodale Welle senkte das vollständige Modell mit Gate den relativen L2-Fehler gegenüber den Ablationen um bis zu 59,2 %. Bei Burgers waren gelerntes Gate und fester Mittelwert nicht zu unterscheiden, und beim einmodigen Testfall 1D-Welle gewann der feste Mittelwert um rund 53 %. Das berichtete Muster lautet, dass der Nutzen der spektralen Komplexität folgt, mit einem Seed pro Ergebnis und Reaktions-Diffusion als offener Ausnahme.
Wie sollten die Ergebnisse in der Praxis genutzt werden?
Als prüfbare Hypothese, nicht als Regel. Bevor ein frequenzzerlegtes PINN übernommen wird, sollte der spektrale Gehalt des Problems geprüft und eine passende Ablation auf repräsentativen Fällen gefahren werden, genau wie im Paper. Ist die Lösung glatt und einskalig, kann ein einfacheres Modell das Design mit Gate erreichen oder schlagen, und ein Vergleich über mehrere Seeds ist nötig, bevor einer Reihenfolge vertraut wird.
Quellen
- Rai, S. (2026). When Does Frequency Decomposition Benefit Physics-Informed Neural Networks? A Preliminary Ablation Study. arXiv:2608.24940. https://arxiv.org/abs/2608.24940 (externe Website)
- Raissi, M., Perdikaris, P. and Karniadakis, G. E. (2019). Physics-informed neural networks: A deep learning framework for solving forward and inverse problems involving nonlinear partial differential equations. Journal of Computational Physics, 378, 686 to 707. https://doi.org/10.1016/j.jcp.2018.10.045 (externe Website)
- Rahaman, N. et al. (2019). On the spectral bias of neural networks. Proceedings of the 36th International Conference on Machine Learning, PMLR 97. https://proceedings.mlr.press/v97/rahaman19a.html (externe Website)
- Tancik, M. et al. (2020). Fourier features let networks learn high frequency functions in low dimensional domains. Advances in Neural Information Processing Systems 33. https://arxiv.org/abs/2006.10739 (externe Website)
- Sitzmann, V. et al. (2020). Implicit neural representations with periodic activation functions. Advances in Neural Information Processing Systems 33. https://arxiv.org/abs/2006.09661 (externe Website)
- Lu, L., Meng, X., Mao, Z. and Karniadakis, G. E. (2021). DeepXDE: A deep learning library for solving differential equations. SIAM Review, 63(1), 208 to 228. https://doi.org/10.1137/19M1274067 (externe Website)