
Retrieve-for-Train: Wie ein kleines Diffusionsmodell das Query-Fan-out-Retrieval beschleunigt
Retrieve-for-Train (R4T) verlagert das aufwendige Schlussfolgern hinter dem Query-Fan-out aus dem laufenden Suchpfad. Reinforcement Learning erschließt gutes Fan-out-Verhalten vorab und offline, danach bildet ein Diffusionsmodell mit 53,9 Mio. Parametern es in einem Durchlauf nach, laut den Autoren 12- bis 20-mal schneller.
Was ist Query-Fan-out-Retrieval?
Query-Fan-out-Retrieval zerlegt eine breite Anfrage in mehrere engere Teilanfragen, führt jede gegen eine Datenbank aus und fasst die Ergebnisse zu einer Menge zusammen. Das passt zu Suchen, bei denen Menschen eine Auswahl statt eines einzigen besten Treffers erwarten: Wer nach Campingausrüstung sucht, sollte Zelt, Schlafsack, Kocher und Stirnlampe sehen, nicht zehn Varianten desselben Zelts.
Das Paper nennt dies mengenwertiges Retrieval. Die Qualität gehört zur Sammlung als Ganzes: wie vielfältig sie ist, wie vollständig sie die Absicht abdeckt, wie gut sich ihre Teile ergänzen und ob jedes Element tatsächlich in der Datenbank existiert. Solche Eigenschaften lassen sich nicht zerlegen; wer jedes Ergebnis einzeln bewertet, wie es klassisches Learning-to-Rank tut, kann sie nicht messen.
Viele verschiedene Mengen können dieselbe breite Absicht erfüllen, daher gibt es selten eine einzige richtige Antwort zum Annotieren. Herkömmliche Trainingsdaten aus Paaren von Anfrage und bestem Einzeltreffer passen deshalb schlecht, und annotierte Beispiele guter Mengen zu sammeln ist teuer und subjektiv.
Warum tun sich allgemeine Sprachmodelle mit Query-Fan-out schwer?
Allgemeine Sprachmodelle können Teilanfragen schreiben, doch die Autoren benennen zwei Schwächen. Die Teilanfragen wiederholen einander, und gute Teilanfragen erfordern lange Ketten von Reasoning-Tokens, deren Latenz ein Live-Suchfeld nicht verkraftet.
Hinzu kommt die Verankerung. Ein generisches Modell kennt die Struktur eines bestimmten Katalogs nicht und schlägt daher Teilanfragen vor, denen dort nichts Reales entspricht.
- Paraphrastischer Kollaps. Ohne Wissen über den Datenbestand liefert ein Modell, das „Bohemian festival style“ erweitern soll, oft kaum mehr als Umformulierungen. Die Ergebnisse wirken einheitlich und lassen Facetten wie Wildlederstiefel, Häkelkleider oder Fransenjacken aus, die eine erfahrene Stylistin ergänzen würde.
- Sequenzielle Latenz. Autoregressive Modelle erzeugen ein Token nach dem anderen, und die Planung einer guten Zerlegung kann Hunderte Zwischen-Tokens kosten, bevor der erste Suchbegriff erscheint. Werden viele Teilanfragen gleichzeitig benötigt, summieren sich die Kosten; laut den Autoren entsteht so eine Latenzuntergrenze, die mit einer Suche unter einer Sekunde kollidiert.
Wie funktioniert Retrieve-for-Train?
Retrieve-for-Train führt Reinforcement Learning einmal offline aus und verwandelt das Gelernte in Trainingsdaten für ein schnelles Modell. Die Autoren beschreiben RL hier als Zielwandler (objective transducer): ein Weg, ein schwer annotierbares Ziel in gewöhnliche überwachte Beispiele zu übersetzen.
Das Diffusionsmodell nutzt eine Variance-Exploding-Formulierung im EDM-Framework, erhält das Anfrage-Embedding über Cross-Attention und verwendet Classifier-free Guidance. Bei offenen Aufgaben sind seine Ziele die Embeddings abgerufener Elemente, bei der schwach überwachten Aufgabe die Embeddings der gelernten Teilanfragen; so übernimmt das Modell die Zerlegungsstrategie selbst.
Die Autoren testen zwei Einsatzformen. R4T-FOLM betreibt das per RL abgestimmte Sprachmodell direkt und zeigt, welche Qualität das gelernte Verhalten erreicht, behält aber die autoregressive Latenz. R4T-Diffusion betreibt das destillierte Diffusionsmodell und prüft, ob dieses Verhalten einen einzigen schnellen Durchlauf übersteht.
- Stufe 1: Fan-out-Sprachmodell trainieren. Ein offenes Modell mit 4B Parametern, in den Experimenten Gemma3-4B oder Qwen3-4B, lernt per Reinforcement Learning, für jede breite Anfrage 10 Teilanfragen zu schreiben. Ein eingefrorener Retriever führt sie aus, und eine mengenbasierte Belohnung bewertet das Gesamtergebnis.
- Stufe 2: Trainingsdaten synthetisieren. Das trainierte Modell wird eingefroren und erzeugt Fan-outs für einen großen Bestand an Anfragen, 128 Stichproben pro Anfrage bei Temperatur 0,9. Jede Anfrage wird mit einer Zielmenge von Embeddings gespeichert, ganz ohne menschliche Annotation. Die Zeilen der Zielmenge werden beim Training gemischt, weil die Reihenfolge einer Menge keine Bedeutung trägt.
- Stufe 3: Diffusions-Retriever trainieren. Ein Diffusions-Transformer mit 53,9 Mio. Parametern lernt, ein Anfrage-Embedding direkt auf eine ganze Menge von Ziel-Embeddings abzubilden. Zur Abfragezeit erzeugt er alle Suchrichtungen gemeinsam in einem Durchlauf, und jedes ausgegebene Embedding wird seinem nächsten Element in der Datenbank zugeordnet.
Eine Belohnung für die gesamte Ergebnismenge
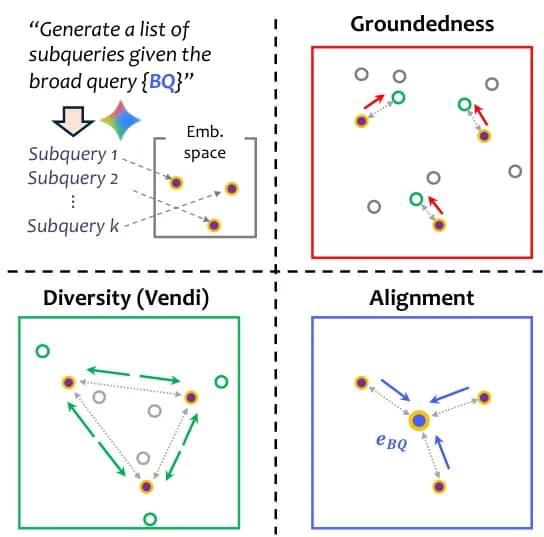
Für offene Anfragen ohne Ground Truth ist die Belohnung eine gewichtete Summe aus drei Werten, berechnet über die gesamte Menge der Teilanfragen. Jeder Term schließt eine Abkürzung, die die anderen offenlassen; die Autoren sprechen daher von gegenseitigen Gegenankern.
Standardmäßig liegen die Gewichte bei 0,6 für Verankerung und je 0,2 für Vielfalt und Ausrichtung. Bei der schwach überwachten Aufgabe, in der jede Anfrage eine plausible Referenzmenge mitbringt, ist die Belohnung schlicht der Anteil der Referenzelemente, den die Vereinigung der Fan-out-Ergebnisse wiederfindet.
Optimiert wird das Fan-out-Modell mit Group Relative Policy Optimization (GRPO), die jede gezogene Ausgabe mit anderen Ausgaben für dieselbe Anfrage vergleicht, kombiniert mit Soft-PPO-Regularisierung, die Vorwärts- und Rückwärts-KL-Strafen hinzufügt, um die offene Generierung zu stabilisieren.
- Verankerung. Belohnt Teilanfragen, deren Embeddings nahe an einem realen Element der Datenbank liegen, gemessen am Abstand zum nächsten Nachbarn. So wird das Modell zu Dingen gelenkt, die es tatsächlich gibt.
- Vielfalt. Wendet den Vendi Score, eine auf paarweiser Ähnlichkeit beruhende Vielfaltsmetrik, auf ein repräsentatives abgerufenes Element je Teilanfrage an. Ein höherer Wert bedeutet, dass sich die Menge über mehr unterschiedliche Bedeutungen verteilt.
- Ausrichtung. Mittelt die Kosinusähnlichkeit zwischen jeder Teilanfrage und der ursprünglichen Anfrage und verhindert so, dass die Menge von dem abdriftet, wonach die Person tatsächlich gefragt hat.
Was passiert, wenn der Belohnung die Vielfalt fehlt?
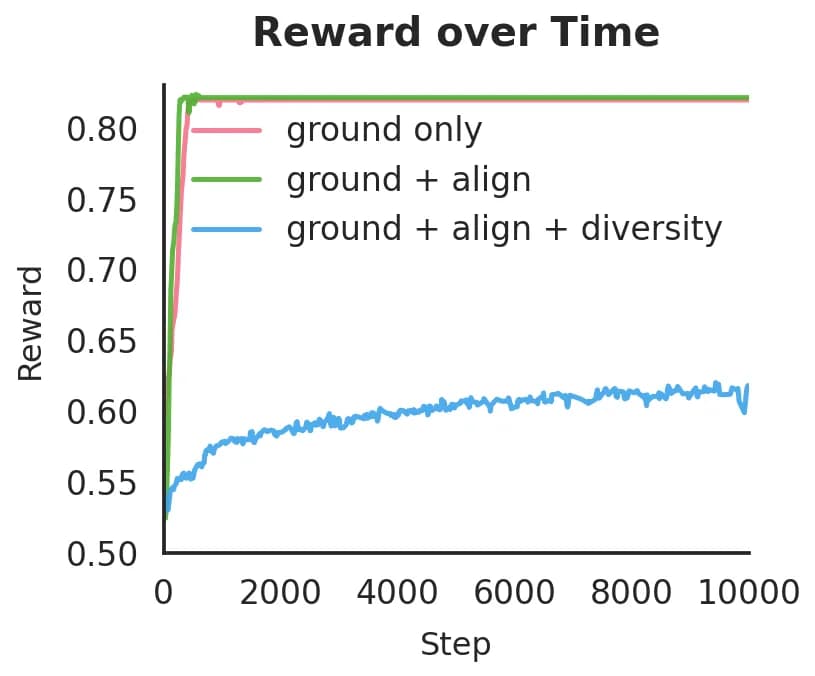
Das Training entgleist schnell. In der Ablationsstudie der Autoren lernte ein nur auf Verankerung belohntes Modell, sinnlose Zeichenketten auszugeben, etwa eine wiederholte Phrase über Zeilenenden, die zufällig nahe an einem Datenbankelement liegen. Mit Ausrichtung, aber ohne Vielfalt, kollabierte es noch schneller in Umschreibungen der ursprünglichen Anfrage.
Nur die vollständige dreiteilige Belohnung ergab ein stabiles Training. Auch die Gewichtung zählt: Dominierte die Verankerung, stieg die Vielfalt, aber die Ausrichtung sank; dominierten Ausrichtung und Vielfalt, wurde die Exploration gebremst. Eine ausgewogene Mischung ließ alle drei Werte konvergieren.
Unsere Analyse: Die Trainingskurven sind eine Warnung für alle, die Retrieval mit Reinforcement Learning abstimmen. Im Diagramm des Papers steigen die beiden ausgetricksten Läufe am schnellsten und pendeln sich bei den höchsten Belohnungswerten ein, während der gesunde Lauf langsam zulegt. Eine steigende Belohnungskurve allein sagt daher wenig darüber, ob das gelernte Verhalten nützlich ist.
Wie gut schneidet Retrieve-for-Train ab?
Laut den Autoren übertraf R4T beim offenen Retrieval jede Fan-out-Baseline innerhalb derselben Modellfamilie und verbesserte bei der schwach überwachten Aufgabe das Verhältnis von Abdeckung und Vielfalt. Die Diffusionsvariante behielt den Großteil der Qualität des per RL abgestimmten Sprachmodells.
Die Experimente nutzen zwei Datensätze. Polyvore ist ein veröffentlichter Mode-Benchmark aus von Nutzern kuratierten Outfits, durchsucht mit einem CLIP-basierten Bild-Text-Encoder über 21.888 Kollektionen für offenes Retrieval und 142.472 Einzelartikel für die schwach überwachte Aufgabe. Der zweite ist ein proprietärer Bestand an von Fachleuten erstellten Musik-Playlists, durchsucht mit dem Musik-Text-Embedding-Modell MuLan über 8.522 Playlist-Embeddings.
Zu den Baselines gehören Retrieval ohne Fan-out, Zero-Shot-Fan-out mit Gemini-2.5-Flash, Gemma3-4B und Qwen3-4B sowie Best-of-N, das Zero-Shot-Fan-out mehrfach ausführt (N=5) und die Ausgabe mit der höchsten Trainingsbelohnung behält.
Beim offenen Retrieval bewertete ein LLM als Gutachter Vielfalt, Ausrichtung und Verankerung auf einer 5-stufigen Skala. Auf Polyvore mit Gemma3-4B stieg der Durchschnitt von 38,5 bei Zero-Shot-Fan-out und 40,9 bei Best-of-N auf 49,1 bei R4T-FOLM, die Vielfalt kletterte von 56,0 auf 76,8. Bei den Musikdaten verbesserte sich der Durchschnitt auf Gemma-Basis von 48,1 bei Zero-Shot-Fan-out auf 58,1 bei R4T-FOLM.
Beim schwach überwachten kompositionellen Retrieval wurde jedes Polyvore-Outfit zu einer Referenzmenge mit einer von einem LLM formulierten breiten Anfrage. R4T-FOLM auf Qwen3-4B erreichte einen Recall@5K von 20,9 und einen Hit@5K von 64,6, gegenüber 15,7 und 52,1 für Zero-Shot mit Gemini-2.5-Flash. Die Diffusionsvarianten tauschten etwas Recall gegen höhere Vendi Scores, was die Autoren als breitere Abdeckung gültiger Alternativen deuten, nicht als geringere Qualität.
Wie viel schneller ist der Diffusions-Retriever?
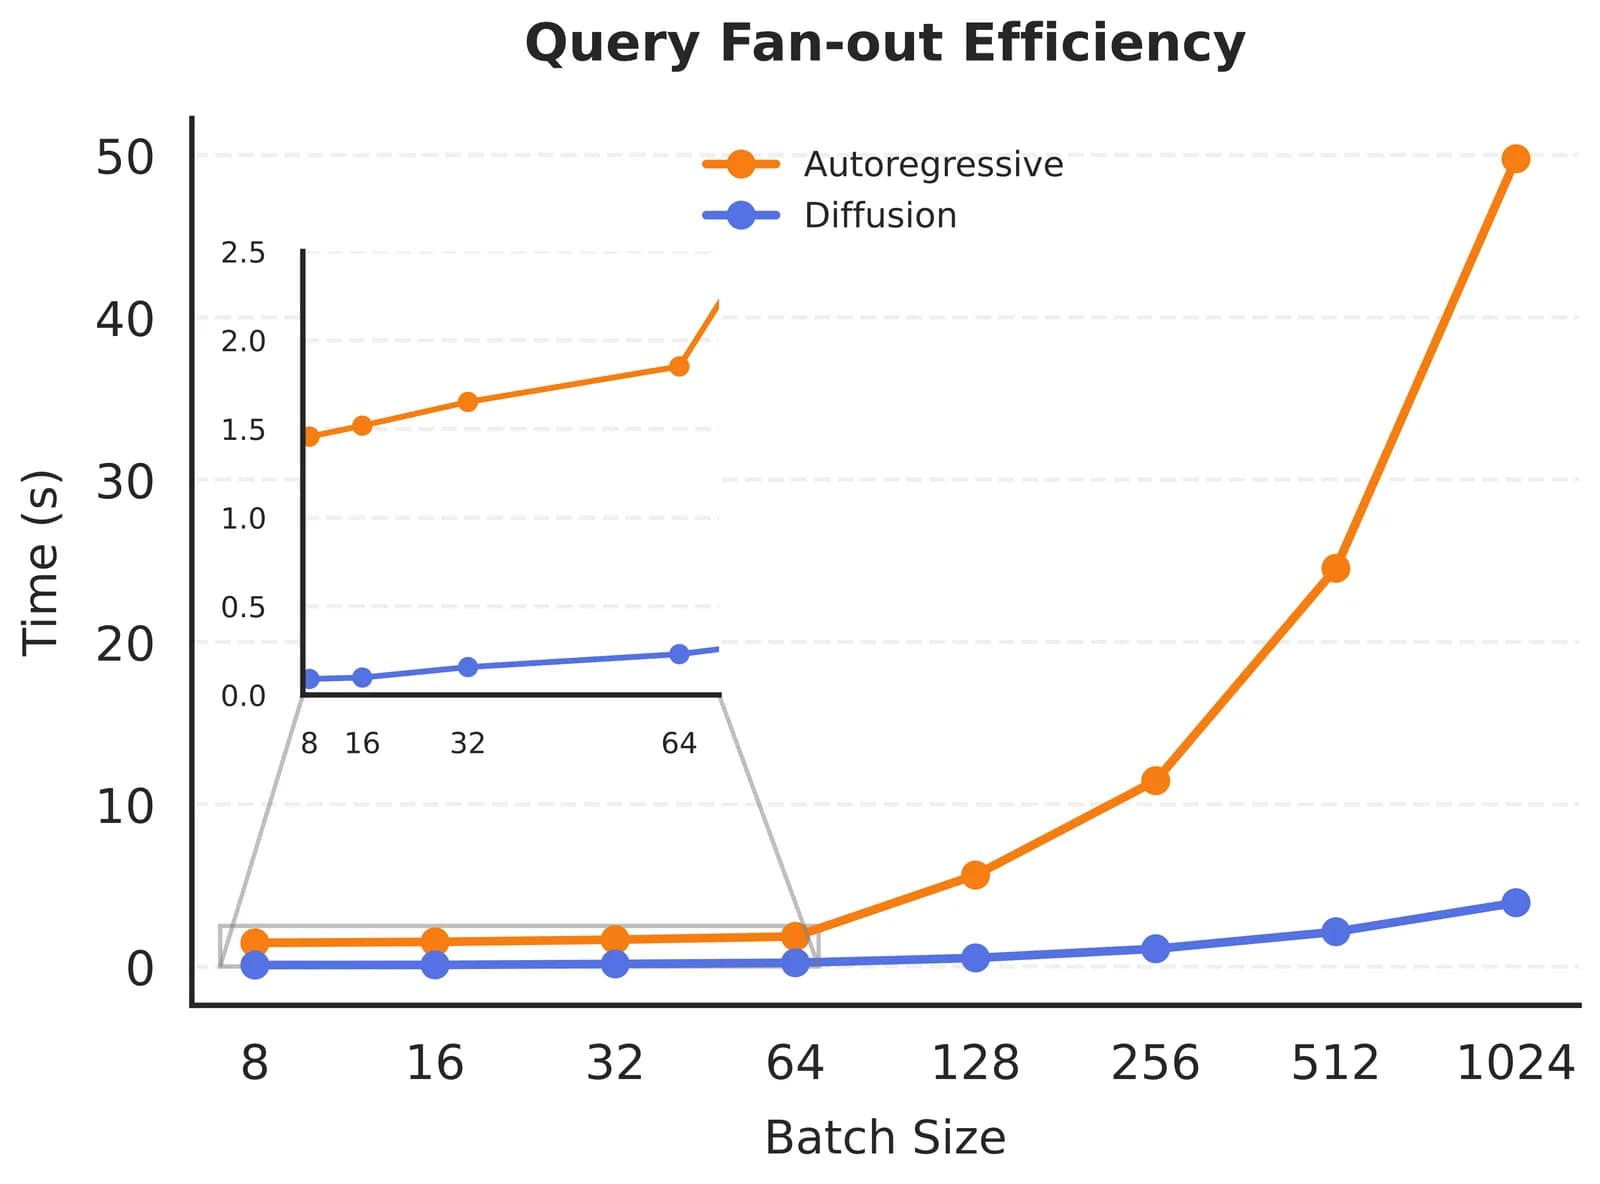
Im Benchmark der Autoren arbeitete der Diffusions-Retriever 12- bis 20-mal schneller als autoregressives Fan-out, wenn er 10 Suchrichtungen erzeugte. Für einen Batch von 8 Anfragen brauchte er 0,07 Sekunden statt etwa 1,46 Sekunden, für einen Batch von 1.024 Anfragen 4,21 Sekunden statt fast 50 Sekunden.
Beim Sprachmodell dominiert bei kleinen Batches ein fester Grundaufwand, danach wächst die Zeit ungefähr proportional zur Batchgröße. Das Diffusionsmodell vermeidet Token-für-Token-Decodierung, weil es alle Ziel-Embeddings gemeinsam in einem kontinuierlichen Raum entrauscht, und seine geringe Größe hält den Speicherbedarf im Betrieb niedrig.
Best-of-N, die stärkste Baseline, geht in die Gegenrichtung. Sie braucht für jede Anfrage mehrere unabhängige Fan-out-Läufe, was laut den Autoren die Inferenzkosten um eine Größenordnung erhöht.
Grenzen und offene Fragen
Die Autoren nennen vier Grenzen: Die Offline-RL-Stufe ist aufwendig, die Methode braucht Ziele, die sich als explizite Belohnungen formulieren lassen, die Qualität offener Ergebnisse bewertete ein Sprachmodell, und die Ergebnisse können von den gewählten Modellen, Embedding-Räumen und der Diffusionsarchitektur abhängen.
Zum Aufwand: Die RL-Stufe interagiert vielfach mit dem Retriever, und die Autoren merken an, dass diese Vorarbeit bei sehr großen oder häufig wechselnden Datenbanken erheblich sein kann. Zu den Belohnungen: Eigenschaften wie Kreativität, Neuheit oder kulturelle Sensibilität lassen sich schwer als einzelner Wert ausdrücken; die Autoren schlagen vor, Belohnungen aus Nutzerfeedback zu lernen.
Das Paper benennt zudem ein ethisches Risiko. Eine unbedacht festgelegte Belohnung könnte Verzerrungen kodieren oder verstärken, und synthetische Trainingsdaten könnten sie in großem Maßstab verbreiten. Die Autoren fordern deshalb domänenspezifische Bias-Audits und menschliche Aufsicht.
Unsere Analyse: Zwei Details erschweren die unabhängige Prüfung. Die Musikergebnisse beruhen auf einem proprietären Datensatz, und das Paper nennt im Haupttext Gemini-2.5-Pro als Gutachter, in einem Anhang jedoch Gemini-2.5-Flash.
Warum das für Suche und Empfehlungen im Unternehmen zählt
Das Grundmuster lässt sich übertragen: Rechenleistung einmal offline einsetzen, um ein Verhalten zu finden, das pro Anfrage zu langsam wäre, und es dann in ein kleines Modell destillieren, das den Live-Verkehr bedient. Für Katalogsuche, Content Discovery und Empfehlungslisten könnte das vielfältige Ergebnismengen ohne Reasoning-Modell im Anfragepfad bedeuten.
R4T adressiert zudem eine verbreitete Datenlücke. Viele Organisationen besitzen einen Katalog und Embeddings, aber keine annotierten Beispiele dafür, wie eine gute Ergebnismenge aussieht. Die Methode ersetzt diese Labels durch eine explizite Belohnung und verlagert den Aufwand damit in deren sorgfältige Definition und in die Prüfung dessen, was sie fördert.
Unsere Analyse: Teams, die den Ansatz prüfen, sollten klären, wie oft das Fan-out-Modell bei Katalogänderungen neu trainiert werden muss, wie sich Belohnungsgewichte auf die eigene Domäne übertragen lassen und wie sich Mengenqualität messen lässt, ohne sich allein auf ein LLM als Gutachter zu verlassen.
Ist der Code von Retrieve-for-Train verfügbar?
Weder der Beitrag noch das Paper kündigt eine Veröffentlichung von Code, trainierten Modellen oder den synthetischen Trainingsdaten an. Das Paper von Pengcheng Jiang, Judith Yue Li und neun Mitautoren steht auf arXiv unter einer CC-BY-4.0-Lizenz, und der Beitrag der Autoren bezeichnet es als Paper der ICML 2026.
Die Bausteine sind öffentlich: Gemma3-4B und Qwen3-4B sind offene Modelle, Polyvore ist ein veröffentlichter Benchmark, und der Anhang des Papers listet die Trainingseinstellungen auf, darunter einen Diffusions-Transformer mit 6 Schichten, 16 Attention-Heads und 256 Sampling-Schritten.
Fragen und Antworten
Worin unterscheiden sich R4T-FOLM und R4T-Diffusion?
Beide Varianten teilen dieselbe Reinforcement-Learning-Stufe. R4T-FOLM betreibt das per RL abgestimmte Fan-out-Sprachmodell direkt, schreibt Teilanfragen Token für Token und ruft für jede den Retriever auf; das brachte die beste gemessene Qualität, behält aber die autoregressive Latenz. R4T-Diffusion betreibt ein Diffusionsmodell mit 53,9 Mio. Parametern, das auf den Ausgaben dieses Modells trainiert wurde, und erzeugt alle Embeddings in einem Durchlauf. Laut den Autoren behielt es den Großteil der Qualität und lief 12- bis 20-mal schneller.
Braucht Retrieve-for-Train von Menschen annotierte Trainingsdaten?
Nein. Die Trainingspaare für den Diffusions-Retriever stammen vom per RL abgestimmten Fan-out-Modell, das offline Teilanfragen und Suchziele für jede breite Anfrage erzeugt. Menschliches Urteil fließt über das Design der Belohnung ein, die Verankerung, Vielfalt und Ausrichtung kodiert, sowie über die Wahl ihrer Gewichte. Bei der schwach überwachten Aufgabe dienen vorhandene kuratierte Mengen wie Polyvore-Outfits als Referenzmengen für eine Abdeckungsbelohnung.
Was ist der Vendi Score?
Der Vendi Score ist eine Vielfaltsmetrik für maschinelles Lernen, die Friedman und Dieng 2022 vorgestellt haben. Er misst die semantische Breite einer Menge anhand der Ähnlichkeiten zwischen den Embeddings ihrer Elemente; ein höherer Wert bedeutet, dass die Menge mehr unterschiedliche Inhalte abdeckt. R4T nutzt ihn doppelt: als Vielfaltsterm in der Trainingsbelohnung und als Bewertungsmetrik für schwach überwachtes Retrieval über fünf unabhängige Läufe.
Kann Query-Fan-out-Retrieval in Echtzeit laufen?
Die Zeitmessungen der Autoren deuten darauf hin, dass der Diffusionsansatz das in Reichweite bringt. Für 10 Suchrichtungen brauchte ihr Diffusionsmodell 0,07 Sekunden für einen Batch von 8 Anfragen und 4,21 Sekunden für einen Batch von 1.024, während autoregressives Fan-out etwa 1,46 Sekunden und fast 50 Sekunden benötigte. Die Latenz im Produktivbetrieb hängt zudem von Vektorindex, Ranking und Serving-Stack ab, die der Benchmark nicht abdeckt.
Quellen
- Jiang, P., Li, J. Y., Ryu, M., Hu, R. L., Su, K., Wan, Z. Y., Hebert, L., Peng, H., Han, J., Kuzmin, D., & Boutilier, C. (2026). Efficient, property-aligned fan-out retrieval via RL-compiled diffusion. arXiv:2603.06397. https://arxiv.org/abs/2603.06397 (externe Website)
- Friedman, D., & Dieng, A. B. (2022). The Vendi Score: A diversity evaluation metric for machine learning. arXiv:2210.02410. https://arxiv.org/abs/2210.02410 (externe Website)
- Han, X., Wu, Z., Jiang, Y.-G., & Davis, L. S. (2017). Learning fashion compatibility with bidirectional LSTMs. Proceedings of the 25th ACM International Conference on Multimedia, 1078-1086. arXiv:1707.05691. https://arxiv.org/abs/1707.05691 (externe Website)
- Huang, Q., Jansen, A., Lee, J., Ganti, R., Li, J. Y., & Ellis, D. P. W. (2022). MuLan: A joint embedding of music audio and natural language. arXiv:2208.12415. https://arxiv.org/abs/2208.12415 (externe Website)
Originalbeitrag
Jiang, P., & Li, J. Y. (2026, 15 September). Bypassing inference bottlenecks: Accelerating complex AI search with Retrieve-for-Train. Google Research Blog. https://research.google/blog/bypassing-inference-bottlenecks-accelerating-complex-ai-search-with-retrieve-for-train/ (externe Website)