
Wie Agenten lange KI-Videos kohärent halten: Co-Director, CANVAS, A²RD und VQQA
Forschende von Google und Partneruniversitäten haben vier agentische Frameworks veröffentlicht, die Drift und Folgefehler bekämpfen, wenn lange KI-Videos entstehen. Co-Director plant die kreative Richtung, CANVAS verfolgt die Welt der Geschichte, A²RD baut minutenlange Videos Segment für Segment auf, und VQQA repariert Clips, indem es ihnen gezielte Fragen stellt.
Warum sind lange KI-Videos noch so schwer zu erzeugen?
Video-Diffusionsmodelle können einen überzeugenden Clip von wenigen Sekunden erzeugen, doch eine Geschichte braucht viele Clips, die zueinander passen. Von Einstellung zu Einstellung ändert sich die Kleidung einer Figur, Räume ordnen sich neu, Requisiten tauchen auf oder verschwinden. Agentische Pipelines, die Drehbuch, Bildmodell und Videomodell verketten, helfen, doch jede Stufe wird einzeln angesteuert, sodass ein früher Fehler alles Nachfolgende belastet.
Die Autoren beschreiben das als Problem der Zuordnung von Verantwortung, im Fachjargon Credit Assignment: Scheitert ein fertiges Video, lässt sich schwer sagen, welcher vorgelagerte Prompt schuld war. Zudem nennen sie zwei Fehler, die mit der Länge zunehmen. Bei Feature Drift verändern sich Personen und Schauplätze ohne erzählerischen Grund, bei Content Collapse kommt die Handlung nicht mehr voran. Beides von Hand zu reparieren, macht lange KI-Videos langsam und teuer.
Der Beitrag antwortet mit vier Frameworks, die jeweils einen Engpass angehen und als Orchestrierungsschicht über bestehenden Modellen arbeiten, statt selbst neue Videogeneratoren zu sein.
Vier Frameworks für vier Engpässe
Jedes Framework übernimmt eine andere Phase der Produktion, von der Entscheidung, was ein Video aussagen soll, bis zur Reparatur eines einzelnen fehlerhaften Clips. Der Beitrag stellt sie als einander ergänzende Säulen dar, nicht als eine feste Pipeline, und jedes hat eigene Veröffentlichung, Benchmarks und Ergebnisse.
Laut dem Beitrag behalten die Ausgaben, weil das System als Schicht über Gemini und Veo läuft, deren Schutzmechanismen einschließlich SynthID-Wasserzeichen. Zusätzliche Klassifikatoren können das fertig montierte Video prüfen, da einzeln unbedenkliche Clips in der Kombination unerwünscht wirken können.
- Co-Director für die kreative Richtung. Plant die kreative Richtung eines ganzen Videos und sucht die Konfiguration, die bei einem multimodalen Bewertungsmodell am besten abschneidet. Die Arbeit erscheint auf der COLM 2026.
- CANVAS für Storyboards. Führt ein explizites Verzeichnis von Figuren, Orten und Objektzuständen, damit Storyboard-Bilder über Einstellungen hinweg konsistent bleiben. Die Arbeit erscheint auf der EMNLP 2026.
- A²RD für lange Videos. Erzeugt lange Videos Segment für Segment und hält Identität und Schauplatz mit einem multimodalen Gedächtnis und Selbstprüfungen über Minuten stabil.
- VQQA für die Reparatur. Stellt gezielte visuelle Fragen zu einem erzeugten Clip und schreibt mit den Antworten den Prompt um, sodass Fehler ohne Eingriff in die Modellgewichte behoben werden.
Wie plant der KI-Video-Co-Director ein ganzes Video?
Er behandelt ein Video als ein einziges Optimierungsproblem statt als Kette von Prompts. Ein Orchestrator-Agent wählt mit einem Multi-Armed Bandit eine kreative Konfiguration auf drei Achsen: kreative Strategie, Erzählmodus und ästhetischer Archetyp. Diese Wahl wird in den Systemprompt jedes nachgelagerten Agenten geschrieben, sodass Drehbuch, Keyframes, Clips und Ton derselben Absicht dienen.
Agenten für die Vorproduktion erweitern das Briefing zu einer Handlung, fehlenden visuellen Assets und einem Storyboard. Ein Keyframe-Agent legt dann fest, wie Figuren und Szenen aussehen, bevor ein Video-Agent Bewegung und ein Audio-Agent Sprecherstimme und Musik hinzufügt. Handlungen und Keyframes werden bewertet und lokal neu erzeugt, wenn sie nicht genügen, wobei die Keyframes gemeinsam beurteilt werden, damit Abweichungen zwischen ihnen auffallen.
Anschließend bewertet ein multimodales Bewertungsmodell den fertigen Schnitt getrennt auf jeder der drei Achsen. Diese aufgeschlüsselten Bewertungen fließen an den Bandit zurück, der den UCB1-Algorithmus nutzt, und zeigen dem System, welche Wahl half oder schadete. So umgeht es das Credit-Assignment-Problem. Ein Warmstart durch ein Sprachmodell lenkt frühe Entscheidungen auf sinnvolle Einstellungen, weil blindes Ausprobieren teuer ist, wenn jeder Versuch ein gerendertes Video bedeutet.
Das Paper wendet das Framework auf Werbung an, die Erzählkunst und harte Vorgaben zugleich verlangt: Produkt- und Logo-Assets müssen originalgetreu bleiben, ein Publikum muss getroffen und ein Nutzenversprechen vermittelt werden. Die evaluierten Videos sind kurz, vier Einstellungen mit zusammen 12 Sekunden. Die minutenlangen Ergebnisse dieser Reihe stammen daher von A²RD, nicht von Co-Director.
Wie hält CANVAS Figuren und Orte konsistent?
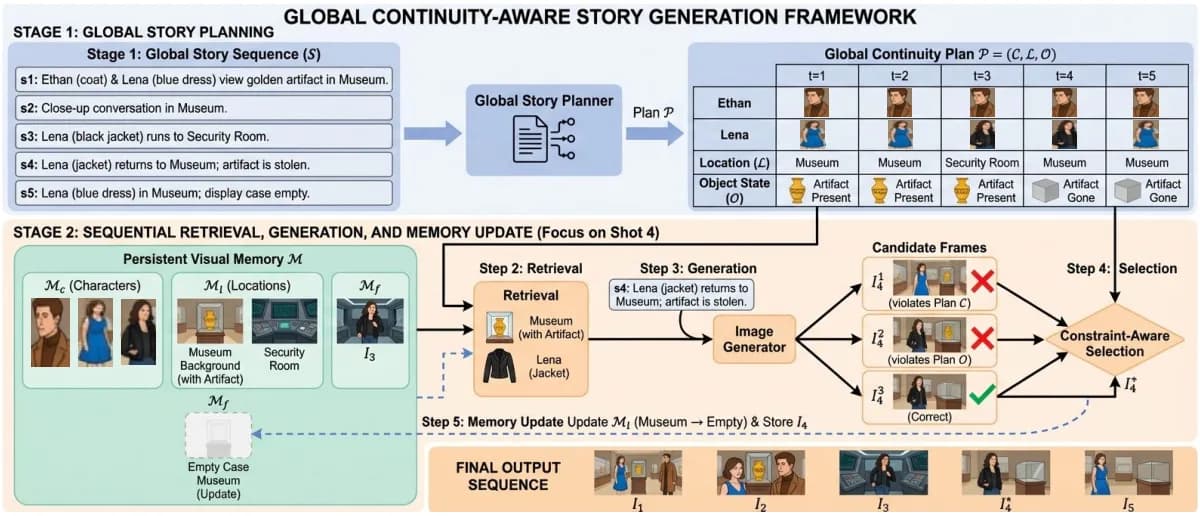
Indem es die Welt der Geschichte ausdrücklich verfolgt. Bevor ein Bild entsteht, liest ein Planer die Liste der Einstellungen und hält fest, welches Outfit jede Figur in jeder Einstellung trägt, welche Einstellungen am selben Ort spielen und wie sich Objekte verändern, etwa ein Artefakt, das erst vorhanden, dann gestohlen und schließlich verschwunden ist. Die Bilderzeugung folgt diesem Plan Einstellung für Einstellung.
Ein dauerhaftes visuelles Gedächtnis speichert Referenzbilder der Figuren, Hintergründe der Orte und die jüngsten Bilder. Bei einer direkten Fortsetzung orientiert sich CANVAS am vorherigen Bild. Kehrt die Handlung aus einem neuen Blickwinkel an einen bekannten Ort zurück, ruft es den gespeicherten Hintergrund ab. An einem neuen Ort beginnt es neu und speichert das Ergebnis. Pro Einstellung entstehen mehrere Kandidaten, die mit aus dem Plan abgeleiteten Fragen bewertet werden, und nach jeder Auswahl wird das Gedächtnis aktualisiert.
CANVAS liefert Storyboards, also eine Folge von Keyframes, und nutzt ein Bildmodell von Gemini als Generator. Es braucht kein Training, und die Autoren vergleichen es mit anderen trainingsfreien Verfahren, die sie auf demselben Basismodell neu implementiert haben.
Wie erzeugt A²RD minutenlange Videos?
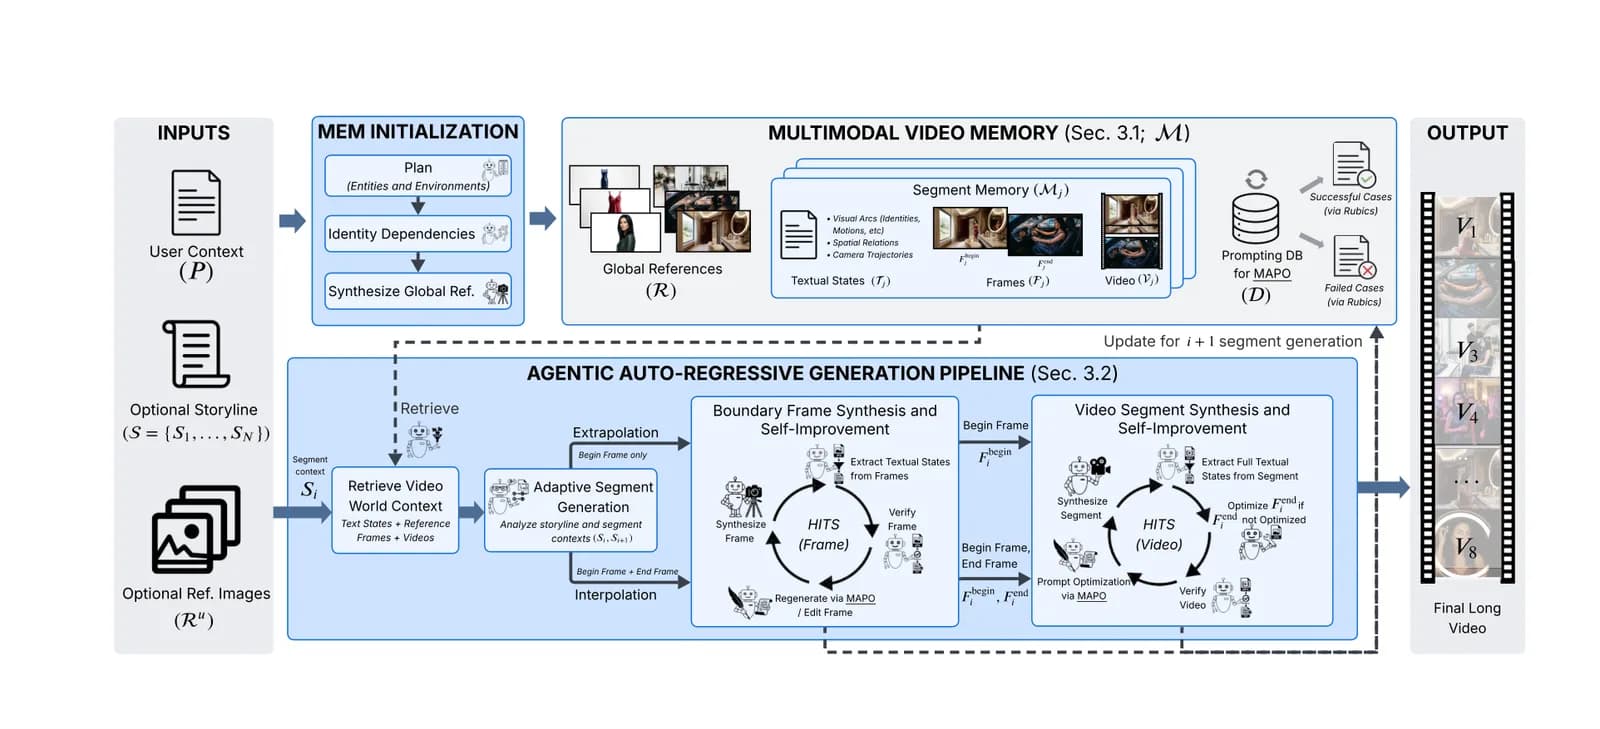
Es baut das Video Segment für Segment in einem geschlossenen Kreislauf auf. Für jedes Segment holt der Agent passenden Kontext aus einem multimodalen Gedächtnis, entscheidet über die Art der Erzeugung, erstellt Randbilder und dann den Clip, prüft und verfeinert beides und schreibt das Ergebnis zurück ins Gedächtnis. Die Autoren nennen das einen Zyklus aus Abrufen, Synthetisieren, Verfeinern und Aktualisieren; Training ist dafür nicht nötig.
Das Gedächtnis hält pro Segment drei Arten von Einträgen fest: Text zu Entitäten, ihren Veränderungen, räumlichen Beziehungen und Kamerabewegungen, dazu Start- und Endbilder sowie den Clip selbst. Vor dem ersten Segment erzeugt der Agent außerdem globale Referenzbilder für jede Figur und jeden Schauplatz und ordnet sie so, dass etwa eine Person erst nach dem Raum entsteht, von dem sie abhängt.
Die zentrale Entscheidung ist adaptiv. Bleibt das nächste Segment am selben Ort, extrapoliert A²RD vom Startbild aus, damit sich die Handlung natürlich entwickeln kann. Springt die Geschichte an einen neuen oder früheren Schauplatz, interpoliert es zwischen geplanten Start- und Endbildern, um das Aussehen festzulegen. Bilder und Clips werden anhand von Katalogen mit acht und zehn Kriterien bewertet und dann bearbeitet oder neu erzeugt, unterstützt von einem Prompt-Optimierer, der aus früheren gelungenen und gescheiterten Korrekturen lernt.
Eine parallele Variante, A²RD-Par, erstellt zuerst alle Randbilder und rendert die Clips dann gleichzeitig. Laut den Autoren hält sie Figuren konsistent, verliert aber etwas Konsistenz der Umgebung und Glätte der Übergänge, ein Zugeständnis an die Geschwindigkeit.
Wie repariert VQQA ein Video ohne Zugriff auf die Modellgewichte?
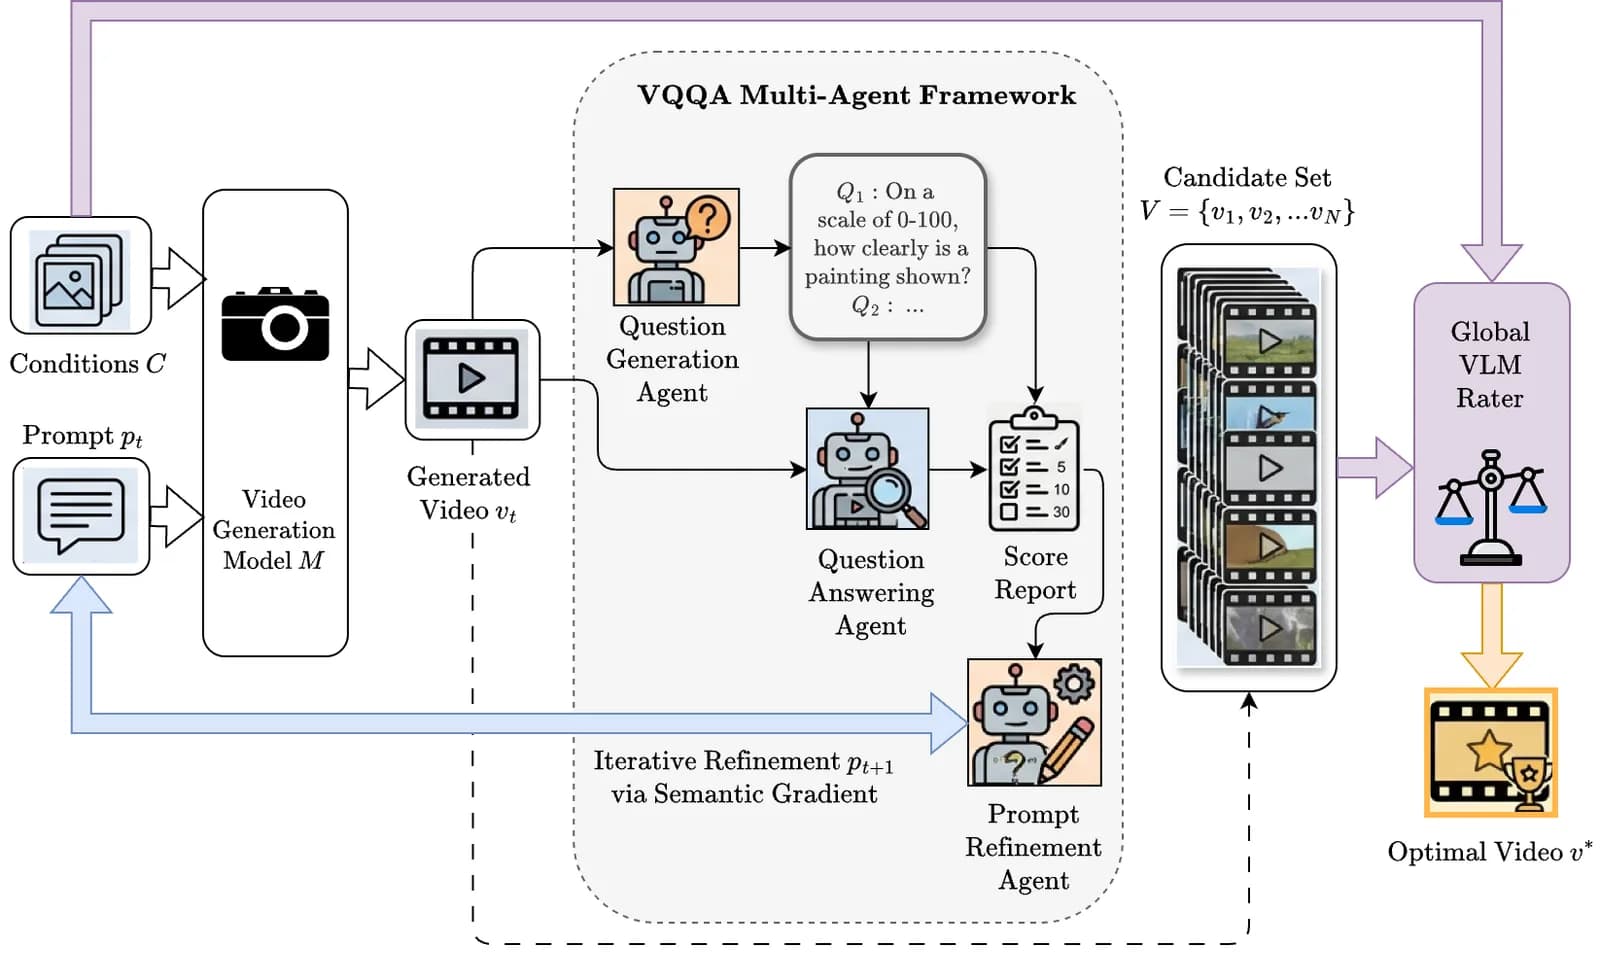
Es bearbeitet den Prompt, nicht die Pixel. Ein Agent zur Fragengenerierung formuliert visuelle Fragen, die auf den Prompt und etwaige Referenzbilder zugeschnitten sind, und deckt dabei Prompt-Treue, visuelle Qualität und Treue zu den Vorgaben ab. Ein zweiter Agent bewertet das Video zu jeder Frage auf einer Skala von 0 bis 100, und ein Verfeinerungsagent schreibt den Prompt um, um die schwächsten Antworten zu beheben, bevor der Generator es erneut versucht.
Die Autoren nennen diese Kritik semantische Gradienten: Rückmeldung in natürlicher Sprache, die die Rolle numerischer Gradienten im Training übernimmt, allerdings über eine Black-Box-Schnittstelle. Weil wiederholte Korrekturen vom ursprünglichen Wunsch abdriften können, bewertet ein separater globaler Bewerter jeden Kandidaten anhand des ursprünglichen Prompts und behält den besten. Die Schleife endet, sobald ein Kandidat die Zielbewertung erreicht oder keine Fortschritte mehr erzielt werden.
Der Beitrag zeigt zwei Beispiele: einen quaderförmigen Ballon, den das Basismodell als starren Würfel ohne Textur darstellt, und ein Duett, in dem eine Musikerin nach einem Schnitt plötzlich das Instrument ihres Partners spielt. In beiden Fällen führte der überarbeitete Prompt den Generator zu einem stimmigen Ergebnis.
Welche Ergebnisse berichten die Autoren?
Jede Arbeit meldet Zugewinne gegenüber den gewählten Vergleichsverfahren, überwiegend auf automatischen Kennzahlen, die multimodale Modelle vergeben, mit Studien an Menschen als Gegenprobe. Die folgenden Zahlen stammen von den Autoren selbst. Da sich die Benchmarks unterscheiden, lassen sich die Werte nicht zwischen den Frameworks vergleichen.
Drei der Benchmarks sind neu und wurden von den Teams gebaut, um Fehler aufzuspüren, die bestehende Tests kaum erfassen. Alle drei beruhen auf fiktivem oder von Modellen erzeugtem Material. GenAD-Bench kombiniert 200 fiktive Produkte von 50 fiktiven Marken mit je einem stereotypen und einem unkonventionellen Publikum und kommt so auf 400 Werbeszenarien; die fiktiven Marken sollen Urheberrechtskonflikte und auswendig gelernte Trainingsdaten ausschließen. HardContinuityBench, erstellt mit GPT-5.2, füllt Storyboards mit langen Pausen vor der Rückkehr von Szenen, Kostümwechseln und Requisiten, die ihren Zustand ändern; die Autoren räumen ein, dass er klein ist. LVbench-C enthält reine Textszenarien für Videos von drei, fünf und zehn Minuten, in denen Figuren, Objekte und Schauplätze für mindestens 10 Segmente verschwinden, bevor sie zurückkehren.
- Ergebnisse von Co-Director. Auf GenAD-Bench erreichte es im Schnitt 81,4 von 100 Punkten, gegenüber 75,7 für eine Zufallssuche über dieselben kreativen Optionen, 68,5 für die eigene, nicht optimierte Pipeline und 63,6 für Veo 3.1 allein. In einer Studie mit Menschen lagen die mittleren Meinungswerte auf einer Skala von 1 bis 5 bei 3,96 für Co-Director und 3,71 für Veo 3.1.
- Ergebnisse von CANVAS. Gegenüber dem stärksten Vergleichsverfahren berichten die Autoren Konsistenzgewinne von 21,6 % bei Hintergründen, 9,6 % bei Figuren und 7,6 % bei Requisiten. Annotierende bevorzugten CANVAS in bis zu 90,9 % der paarweisen Vergleiche mit AutoStudio und in 68,3 % gegenüber dem stärksten Vergleichsverfahren.
- Ergebnisse von A²RD. Bei einminütigen Videos aus VBench-Long erreichte es eine erzählerische Kohärenz von 0,90 gegenüber 0,75 für das beste Vergleichsverfahren und eine Figurenkonsistenz von 0,74 gegenüber 0,57. Menschliche Bewertende vergaben im Schnitt 4,68 von 5 Punkten, gegenüber 3,93 für VideoMemory. Bei zehnminütigen Szenarien bezifferte ein Bewertungsmodell die Figurenkonsistenz auf 90,5 %, die von Objekten auf 91,5 % und die von Umgebungen, dem schwierigsten Fall, auf 84,0 %.
- Ergebnisse von VQQA. Mit dem offenen Generator CogVideoX-5B hob es den Durchschnitt auf T2V-CompBench von 41,89 % auf 53,46 %, ein absoluter Zuwachs von 11,57 Punkten, und verbesserte VBench2 um 8,43 Punkte. Mit Veo 3.1 stieg derselbe Durchschnitt von 55,93 % auf 61,81 %. In den Läufen mit CogVideoX-5B auf T2V-CompBench stoppte es im Mittel nach 1,245 Verfeinerungsrunden, also nach etwa 7,23 Aufrufen des Vision-Language-Modells pro Prompt.
Grenzen und offene Fragen
Einige Grenzen benennen die Arbeiten selbst. A²RD erzeugt pro Segment unter Umständen sechs Videos und sechs Bilder und braucht mehr Rechenleistung als seine Vergleichsverfahren. Die sequenzielle Schleife von VQQA ist langsamer als paralleles Best-of-N-Sampling. CANVAS wird teuer, wenn es pro Einstellung mehrere Kandidaten erzeugt, und bildet feine physische Interaktionen oder komplexe Bewegungen noch nicht ab.
Unsere eigene Lektüre ergibt vier weitere Vorbehalte.
- Bewertungsmodelle benoten die meisten Ergebnisse. Co-Director, CANVAS und A²RD stützen sich stark auf multimodale Modelle als Bewerter. Die Autoren gleichen sie mit Menschen ab, und das Bewertungsmodell von Co-Director kommt bei erzählerischen Kriterien nahe an die Übereinstimmung zwischen Menschen heran, folgt der visuellen Qualität aber weniger genau.
- Neue, kleine oder selbst gebaute Benchmarks. Mehrere Kernzahlen stammen aus Benchmarks, die die Autoren selbst erstellt haben. Bei einem neuen Problem ist das nachvollziehbar, macht unabhängige Replikation aber umso wichtiger.
- Kurz gegen lang. Die evaluierten Videos von Co-Director dauern 12 Sekunden. Die Belege für minutenlange Videos beruhen auf A²RD, dessen zehnminütige Ergebnisse von einem Bewertungsmodell auf zehn Szenarien stammen.
- Begrenzt durch die Basismodelle. VQQA kann nicht beheben, was der Generator nicht darstellen kann, und A²RD braucht Komponentenmodelle, die Anweisungen zuverlässig befolgen. Die Autoren von CANVAS warnen zudem, dass bessere Konsistenz die Herstellung irreführender synthetischer Videos erleichtern könnte.
Warum ist das für Videoarbeit in Unternehmen relevant?
Nach unserer Analyse zählt das Muster mehr als jede einzelne Kennzahl. Alle vier Frameworks legen Planung, Gedächtnis und Kritik um Generatoren, die der Nutzer nicht kontrolliert, und genau in dieser Lage sind die meisten Unternehmen mit gehosteten Videomodellen. Expliziter Zustand, etwa ein Verzeichnis, wer in welcher Szene was trägt, macht Fehler zudem leichter nachvollziehbar als ein einzelner undurchsichtiger Prompt.
Die Kosten sind real. Mehr Generatoraufrufe pro Segment erhöhen Ausgaben und Latenz, und Bewertungsmodelle müssen an den Prüfenden kalibriert werden, die die Arbeit freigeben. Für Marketing-, Schulungs- oder Produktvideos ist ein realistisches Nahziel, kurze Sequenzen mit weniger manuellen Korrekturen zu erstellen, während längere Erzählungen weiter unter menschlicher Regie stehen, die laut den Autoren in der Hand der Kreativen bleiben soll.
Ist der Code verfügbar?
Teilweise. Die Implementierung von Co-Director liegt im öffentlichen Repository genmedia-izumi-agent von Google Cloud Platform, und die Projektseite führt die Daten als demnächst verfügbar. A²RD hat ein öffentliches Repository unter MIT-Lizenz, das derzeit Projektmaterialien enthält; der Datensatz LVbench-C ist als demnächst verfügbar gekennzeichnet. Die Projektseite von CANVAS kündigt den Code an, und VQQA hat eine Projektseite mit Beispielen.
Alle vier Arbeiten stehen auf arXiv unter CC BY 4.0, was die Wiederverwendung der Abbildungen mit Quellenangabe in diesem Überblick erlaubt.
Fragen und Antworten
Was ist der KI-Video-Co-Director?
So nennt der Beitrag von Google Research eine Reihe agentischer Frameworks für lange Videos und zugleich das zentrale Paper Co-Director. Co-Director wählt mit einem Multi-Armed Bandit eine kreative Strategie, einen Erzählmodus und einen ästhetischen Stil, gibt diese Wahl an jeden Produktionsagenten weiter und lernt aus den Bewertungen eines multimodalen Modells, welche Entscheidungen funktioniert haben.
Wie halten diese Systeme eine Figur über mehrere Einstellungen konsistent?
Sie speichern explizite Referenzen und nutzen sie wieder. CANVAS bewahrt Referenzbilder für das Outfit jeder Figur an jedem Punkt der Geschichte auf und ruft sie für jede Einstellung ab. A²RD speichert Textbeschreibungen, Keyframes und Clips früherer Segmente und erzeugt vor dem Start globale Referenzbilder. Beide prüfen neue Bilder gegen diese Referenzen und erzeugen sie neu, wenn eine Prüfung scheitert.
Braucht VQQA Zugriff auf die Gewichte des Videomodells?
Nein. VQQA arbeitet ausschließlich über Prompts. Es stellt einem Vision-Language-Modell gezielte Fragen zu einem erzeugten Clip, macht aus niedrigen Bewertungen Prompt-Überarbeitungen, ruft den Generator erneut auf und wählt am Ende den Kandidaten, der der ursprünglichen Anfrage am besten entspricht. Laut den Autoren funktionierte es sowohl mit dem offenen Modell CogVideoX-5B als auch mit Veo 3.1.
Wie lang sind die Videos, die diese Frameworks erzeugen?
Das hängt vom Framework ab. Die evaluierten Werbespots von Co-Director bestehen aus vier Einstellungen und dauern 12 Sekunden. A²RD wurde an Videos von etwa einer, drei und fünf Minuten sowie an zehnminütigen Szenarien getestet, und der Beitrag von Google Research zeigt einen damit erstellten Film von zehn Minuten. CANVAS liefert Storyboard-Keyframes statt fertiger Videos.
Können Unternehmen diese Frameworks heute nutzen?
Nicht als fertige Produkte. Der Forschungscode von Co-Director ist öffentlich, A²RD und CANVAS kündigen Daten oder Code an, und alle vier hängen von leistungsfähigen gehosteten Modellen wie Gemini und Veo ab. Teams können die veröffentlichten Entwürfe studieren, sollten aber mit erheblichem Entwicklungsaufwand, Rechenkosten und eigener Evaluation rechnen, bevor sie sich bei Produktionsvideos darauf verlassen.
Quellen
- Song, Y., Song, Y., Losier, N., Hodson, N., Jin, Y., Zhu, R., Xu, Y., Vlasic, D., Claassen, C., Leon, J., LeViet, K. G., Chomyn, Z., Timmons, J., Slatkin, B., Penberthy, S., & Pfister, T. (2026). Co-Director: Agentic generative video storytelling. arXiv:2604.24842. https://arxiv.org/abs/2604.24842 (externe Website)
- Mondal, I., Song, Y., Parmar, M., Goyal, P., Boyd-Graber, J., Pfister, T., & Song, Y. (2026). CANVAS: Continuity-aware narratives via visual agentic storyboarding. arXiv:2604.13452. https://arxiv.org/abs/2604.13452 (externe Website)
- Long, D. X., Song, Y., Kan, M.-Y., Pfister, T., & Le, L. T. (2026). A²RD: Agentic autoregressive diffusion for long video consistency. arXiv:2605.06924. https://arxiv.org/abs/2605.06924 (externe Website)
- Song, Y., Pfister, T., & Song, Y. (2026). VQQA: An agentic approach for video evaluation and quality improvement. arXiv:2603.12310. https://arxiv.org/abs/2603.12310 (externe Website)
- Google Cloud Platform. (n.d.). Ads Co-Director, genmedia-izumi-agent [Computer software]. GitHub. https://github.com/GoogleCloudPlatform/genmedia-izumi-agent/tree/main/demos/backend/ads_codirector (externe Website)
- Long, D. X. (n.d.). AARD: A²RD project repository [Computer software]. GitHub. https://github.com/dxlong2000/AARD (externe Website)
Originalbeitrag
Song, Y., & Song, Y. (2026, 24 September). Automating coherent long-form video generation. Google Research Blog. https://research.google/blog/coherent-long-form-video-generation/ (externe Website)